TL;DR:PostgreSQL 变慢通常不是单一原因,而是“慢查询”和“连接数膨胀”两条线同时出问题。这篇文章教你从数据库本体与应用接入层双管齐下:先开启慢查询日志定位热点 SQL,再用 EXPLAIN ANALYZE 判断是否加索引,接着调整 shared_buffers 等内存参数,最后用 PgBouncer 管住并发连接。按“先定位、再修 SQL/索引、后调参数、最后接连接池”的顺序执行,绝大多数数据库性能问题都能在几小时内收敛。若你用托管型虚拟主机或 VPS(虚拟专用服务器),很多系统级参数受限,需先确认自己有没有 PostgreSQL 的配置权限,再决定从哪一步开始查。
为什么慢查询和连接池要一起看
先说结论:调优没有一步到位的银弹,正确的顺序是“先定位慢查询并修 SQL/索引,再调整数据库参数,最后用连接池管理并发”,。慢查询会拖慢单条语句的响应,连接数膨胀则会在高并发时把数据库压垮,两者往往相伴出现。掌握一套从定位到落地的调优步骤,能显著改善站点和业务的数据库体验。若你的应用层还有别的瓶颈,可一并参考站内 MySQL 慢查询分析与 Redis 持久化与恢复的思路,以及技术教程专区里的数据库运维实践。
指标一:慢查询日志是否开启
PostgreSQL(一款开源关系型数据库管理系统)默认并不会把慢查询都记录下来,需要先开启慢查询日志。通过 log_min_duration_statement 可以设定一个耗时阈值,超过该值的语句会被写入日志。下面在配置文件中做最小修改:
# 编辑 postgresql.conf,重启后生效
log_min_duration_statement = 300
# 也可用 ALTER SYSTEM 动态设置
ALTER SYSTEM SET log_min_duration_statement = 300;
这里把阈值设成 300 毫秒(示例),小于该值的语句不记录。重启或用 SELECT pg_reload_conf(); 重载后,慢语句就会进入日志。你还可以借助自带的统计视图快速查看近期最耗时的查询,而不必等到日志累积:
SELECT query, total_exec_time, calls, total_exec_time / NULLIF(calls,0) AS avg_ms
FROM pg_stat_statements
ORDER BY total_exec_time DESC LIMIT 10;
pg_stat_statements 是 PostgreSQL 自带的查询统计扩展,需先在配置中开启 shared_preload_libraries = 'pg_stat_statements' 并重启才能生效。它按规范化语句粒度累计执行时间与调用次数,是定位热点查询最常用的视角。
指标二:执行计划是否出现顺序扫描
定位到慢语句后,先别急着加索引。用 EXPLAIN ANALYZE 查看实际执行计划,确认瓶颈到底在顺序扫描(Seq Scan)、过滤行数过大还是排序。下面这条命令会真实执行语句并给出每步耗时:
EXPLAIN ANALYZE SELECT * FROM orders WHERE customer_id = 12345 ORDER BY created_at DESC;
如果计划中出现大范围的 Seq Scan(顺序扫描,即全表逐行读取),而 WHERE 条件又频繁出现,通常可以针对该列创建索引。例如上面的 customer_id 与排序字段组合,可建立复合索引来同时加速过滤与排序:
CREATE INDEX idx_orders_customer_created ON orders (customer_id, created_at DESC);
建立索引后重新运行 EXPLAIN ANALYZE,对比执行耗时与扫描行数是否下降。注意,索引并非越多越好:每个索引都会增加写入与维护成本,通常建议只给高频 WHERE/JOIN/ORDER BY 字段建索引,避免为低频字段堆砌冗余索引。
指标三:内存参数是否匹配服务器规格
当 SQL 与索引优化到位后,数据库本身的参数可能仍是瓶颈。PostgreSQL 的 shared_buffers(共享缓冲区,用于缓存数据页的内存)与 effective_cache_size 是几个关键参数,但它们并非越大越好,需要结合服务器内存(内存大小以 GB 计)来设定:
# 以 8GB 内存的服务器为例(示例)
shared_buffers = 2GB
effective_cache_size = 6GB
work_mem = 64MB
maintenance_work_mem = 256MB
上面的取值只是典型起点(示例),实际应结合你的工作负载类型与可用内存调整。例如 work_mem(用于排序与哈希操作的单次内存上限)设得过大,在并发排序时可能被多个会话叠加而挤爆内存;设得过小又会让排序落到磁盘变慢。稳妥的做法是逐步调整并观察内存余量与响应变化。改完参数后,用 pg_ctl reload 或 SELECT pg_reload_conf(); 重载多数参数。max_connections(数据库最大并发连接数)也是常见关注点,但它与连接池策略强相关,具体见下一节。
指标四:连接数是否被耗尽
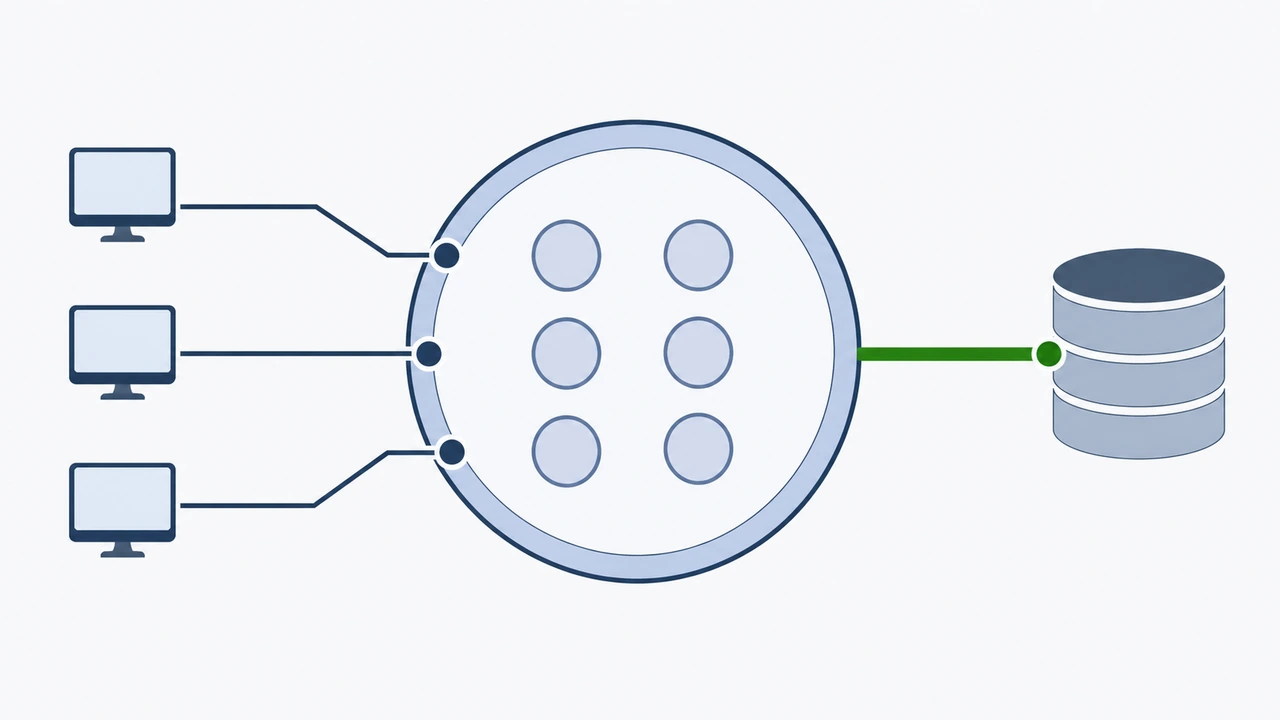
很多数据库变慢并非来自查询本身,而是连接数被耗尽:每个应用实例都建立大量持久连接,堆到 max_connections 上限后,新请求就会排队甚至报错。解决办法是引入连接池,把应用侧的大量连接复用到后端少量数据库连接上。PostgreSQL 生态常用的连接池组件是 PgBouncer(一款轻量的 PostgreSQL 连接池代理),它支持事务级复用,适合 Web 访问模式。安装后按下面的最小配置运行在独立端口:
# /etc/pgbouncer/pgbouncer.ini 最小配置
[databases]
mydb = host=127.0.0.1 port=5432

[pgbouncer]
listen_addr = 127.0.0.1
listen_port = 6432
pool_mode = transaction
max_client_conn = 500
default_pool_size = 20
这里 default_pool_size 设为 20(示例),表示每个数据库最多复用 20 条后端连接,而客户端连接可达 500。通过这种“少后端、多客户端”的方式,应用再怎么横向扩容,也不会把数据库连接数轻易打满。pool_mode = transaction 表示按事务粒度复用连接,适合短事务为主的业务。接入连接池后,应用连接串从 5432 改到 6432 即可。
指标五:连接池与 max_connections 是否匹配
max_connections 与池大小要匹配:数据库侧仍要保留一定的连接余量,避免池内连接全部占用时还有系统进程抢不到连接。一个常见做法是给超级用户或管理任务单独留出几条连接(例如 superuser_reserved_connections),防止业务把连接占满后连维护都进不去。连接池的接入顺序也值得注意:最好先让应用侧稳定运行、确认没有报错后,再把连接串整体切换过去。切换后观察一段时间内的排队数与错误率,若出现连接等待超时,说明 default_pool_size 偏小或慢查询仍占用了池内连接,需要回到前几节把慢查询先处理掉。连接池解决的是“连接数量”问题,不能掩盖“单条查询慢”本身,两者要配套治理。
指标六:调优效果是否可量化
调优是否有效,不能靠感觉,要回到数据说话。建议记录三个可量化指标:慢查询数量、平均查询耗时、数据库连接占用率。在调优前后各抓一次基线,再对比变化:
# 每秒查询/事务数(TPS/QPS)快速观测
pgbench -c 10 -j 2 -T 15 mydb
# 查看当前活跃连接数
SELECT count(*) FROM pg_stat_activity;
pgbench 可以做一个简化的压测来对比调优前后的吞吐,但注意测试时选择低峰时段,避免影响真实业务。连接数与慢查询数则应结合应用日志一起看,判断是否真的下降。
注意事项与行动建议
调优过程中有几处容易踩坑。一是先备份:修改 postgresql.conf 与创建索引前,建议在低峰窗口操作并保留可回滚的变更记录,最好先在测试库或一台预发环境验证参数与索引的效果,再应用到生产。二是索引不能盲目叠加,建索引本身也是写操作,会占用 I/O(输入输出,磁盘读写吞吐)与磁盘空间;每个新增索引都要评估它带来的写入开销。三是连接池引入初期可能对既有工具链(如 psql 直连、备份脚本)有影响,要同步更新连接配置,避免一部分程序走连接池、一部分直连造成行为不一致。
在正式上线前,建议把修改后的配置文件、索引 DDL(数据库定义语句,用于创建或修改表结构)和连接串整理成文档存档。调优是持续过程,随着业务增长,之前的参数可能需要再次调整,把“基线+变更+验证”记录成惯例,比一次性改到最优更实际。给你三条可直接照做的最小行动建议(示例数值截至 2026 年 8 月)。建议一:本周先开启 pg_stat_statements 并抓取 Top 慢查询,建立基线。建议二:对 Top 查询用 EXPLAIN ANALYZE 判断是否需要加索引,逐个落地并验证。建议三:若经常出现连接耗尽,部署 PgBouncer 并调整 max_connections 与池大小。
如果你需要一台拥有完整 root 权限、便于自主配置数据库与各类基础服务的服务器,可以参考服务器排名与选型参考,以及VPS(虚拟专用服务器)主机选购信息,在选型阶段就把数据库调优这类运维需求提前考虑进去。若希望以较低成本启动并逐步扩展,Hostease 这类面向中文站长的主机商提供的 VPS 与独立服务器方案,通常能减少这类运维返工。
 微信扫一扫打赏
 支付宝扫一扫打赏