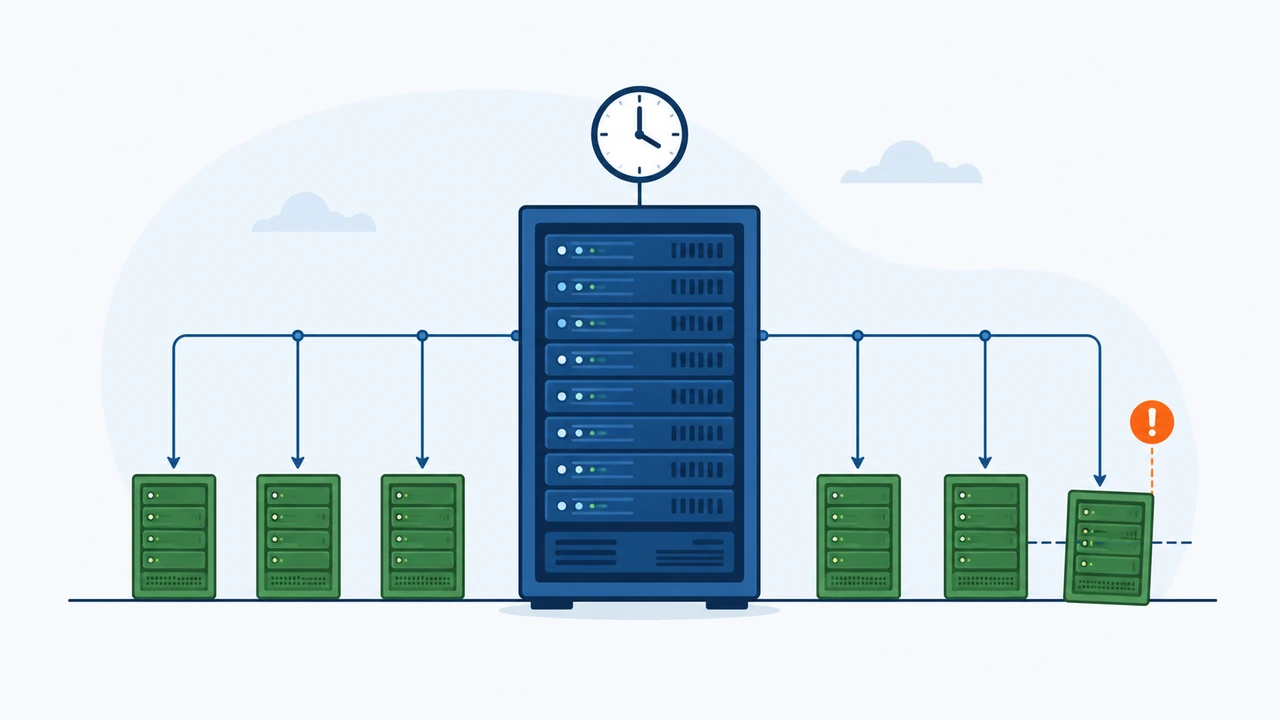
单台服务器时间漂移已经够让人头疼,当一组服务器各自时间不一致时,问题会成倍放大:日志无法跨节点串联、数据库主从复制频繁中断、分布式任务重复或漏执行,排查成本远高于单机场景。本文教你如何用 chrony 搭建多服务器时间同步集群,通过内网时间源统一整组服务器的时间基准,并配合自动化监控及时发现漂移,帮助你从源头避免时间不一致引发的连锁故障。
实践表明,很多团队总觉得”时间差几毫秒无所谓”。但在数据库复制、消息队列、定时任务这些对时间戳敏感的场景里,几十毫秒的相对偏差就可能让事件顺序判断出错。本文不讲空话,而是把主从时间源配置、集群验证、自动化告警和常见排障串成一条可落地的路径。这套方案面向运行多台云服务器(指按需分配 CPU 与内存的云端虚拟服务器实例)、并在这些机器上跑数据库、定时任务或分布式协作的运维场景;单台主机可跳过集群部分,但监控思路同样适用。
为什么多服务器时间一致性比单机更重要
单机时间同步解决的是”这台服务器与真实时间对齐”的问题,而多服务器场景还多了一层”服务器之间彼此对齐”的要求。即使每台服务器都各自与外部时间源同步,由于网络延迟、同步频率和硬件晶振差异,它们之间仍可能产生几十毫秒甚至更大的相对偏差。对依赖时间戳判断事件顺序的分布式系统来说,这个相对偏差才是真正的隐患。以常见业务为例:微服务下多个实例通过时间戳判断请求先后,时间不一致会让日志链路追踪错乱;数据库主从复制依赖 binlog 时间戳排序,主从偏差过大会导致复制中断或数据错位;定时任务调度器部署在多台机器上,时间不一致会让同一任务被重复或漏触发。
要解决这个问题,最有效的做法是让整组服务器共享同一个时间基准。NTP(网络时间协议,通过分层的时间服务器把 UTC 标准时间逐级传递)是标准协议,而 chrony 是 NTP 的现代实现,在集群场景下尤其适合:它支持一台服务器同时作为内网时间源和外部时间源的客户端,还能在同步源短暂不可用时继续维持稳定时间,因此成为主流 Linux 发行版默认的时间同步工具。若你刚接触服务器运维,可先读这篇美国服务器跑国内项目的跨境访问实测,了解集群初始化前容易忽略的前提项。
chrony 集群的典型部署结构
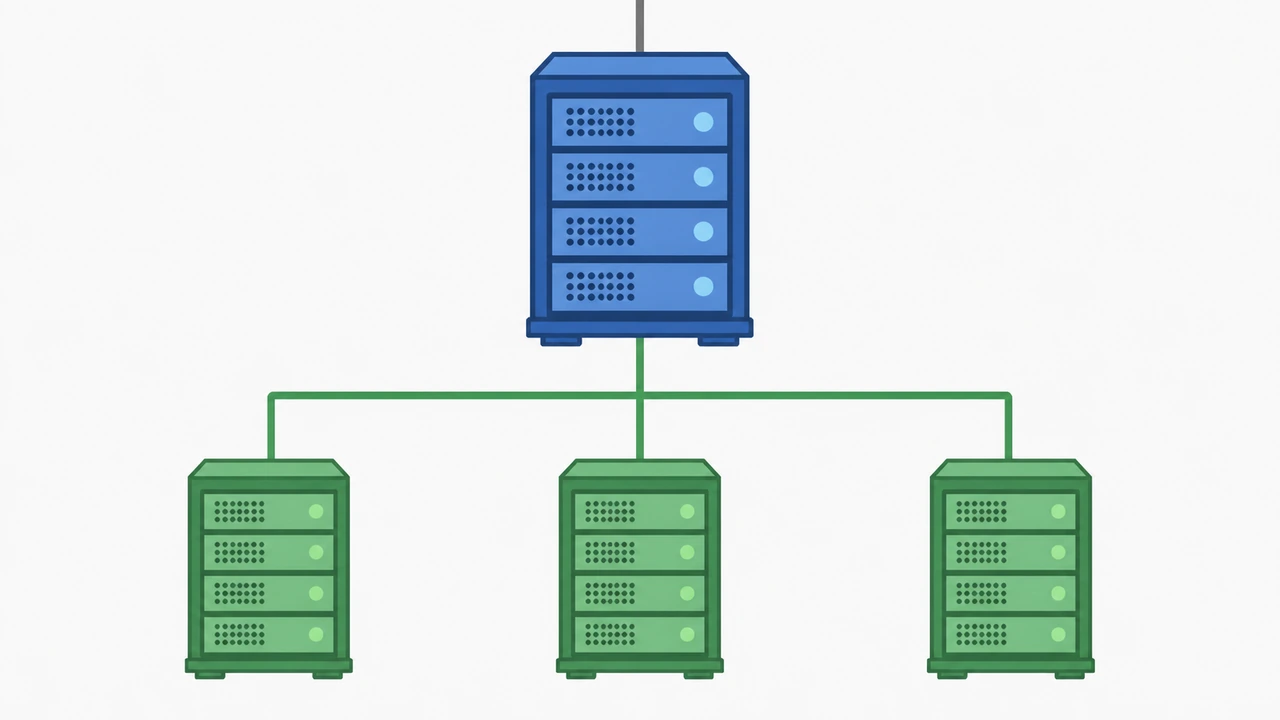
多服务器时间同步集群的典型架构是”一台主时间源 + 多台从服务器”。主时间源同时连接外部权威时间源和内网,从服务器只指向主时间源,这样既能保证整组时间与真实时间对齐,又能让服务器之间保持高度一致。下面按角色说明配置方法。
配置主时间源
主时间源同时承担两个角色:作为客户端从外部同步,作为服务端为内网提供时间。编辑 /etc/chrony.conf,用 server 指令配置外部时间源,用 allow 指令指定允许访问的内网网段。以常见配置为例:
# 外部权威时间源,iburst 表示启动时快速补偿
server ntp.aliyun.com iburst
server ntp.tencent.com iburst

# 只放行内网网段,避免把时间服务暴露到公网
allow 192.168.1.0/24
配置完成后重启 chrony 服务让它生效:
systemctl restart chronyd
systemctl enable chronyd
关键是 allow 指令只写内网网段,不要写成 allow all。UDP 123 端口一旦对公网开放,任何人都能向你的主机发起时间请求,既消耗带宽(指单位时间可传输的数据量),也增加了被利用来放大流量攻击的风险。云厂商安全组和本机防火墙是两层,都要放开内网 UDP 123,公网方向保持关闭。
配置从服务器
从服务器只需要指向主时间源,编辑 /etc/chrony.conf,写入主时间源的内网 IP,并注释掉默认的公共时间源,避免同时连接多个来源导致时间抖动:
# 注释掉默认公共源
# pool 2.debian.pool.ntp.org iburst

# 只指向主时间源的内网 IP
server 192.168.1.10 iburst
这里的 192.168.1.10 需要替换成你主时间源实际的内网 IP。重启 chronyd 后,从服务器会定期与主时间源对齐,通常几分钟内即可把偏差收敛到毫秒级。只保留一个来源,是因为多个来源若延迟差异明显,会让 chrony 在选择和加权时抖动,反而不利于集群内部稳定。
验证集群同步状态
验证是部署中最容易忽略的一步,也是最能暴露配置问题的一步。在主时间源上执行:
chronyc sources -v
chronyc tracking
chronyc sources -v 的输出中,^* 前缀表示该来源已同步且可用;chronyc tracking 则显示系统时钟与来源的偏差值(System time 字段),正常情况下应在毫秒级。在每台从服务器上做同样的检查,应看到主时间源被标记为 ^*。如果从服务器显示 ^?,说明无法连接主时间源,应优先检查防火墙是否放行了 UDP 123 端口,以及 allow 网段是否覆盖了从服务器的地址。
自动化监控:让时间漂移在影响业务前被发现
集群部署完成后,时间一致性不会自动保持。硬件晶振会随温度和老化漂移,网络抖动也会影响同步精度,所以需要持续监控而不是装完就忘。最值得监控的是每台服务器与时间源的偏差值,以及时间源状态:偏差值用 chronyc tracking 的 System time 字段读取(正常应在毫秒级),状态则看 chronyc sources 中是否有 ^* 前缀。
写一个定时脚本,每 5 分钟解析一次 chronyc tracking 的偏差值,超过阈值就通知。脚本放在 cron 里:
*/5 * * * * /usr/local/bin/check_chrony.sh
脚本逻辑不复杂:调用 chronyc tracking 提取 System time 的偏移值(用 awk 或 grep 取数值),与阈值(例如 100 毫秒)比较,超过就调用通知命令(如 curl 发到企业微信/钉钉 webhook,或 mail 发邮件)并记日志。脚本要写得健壮:chronyc tracking 偶尔会因守护进程未就绪返回空值,此时应跳过本轮而不是误报,建议连续 N 次超阈值才告警,减少打扰。
如果你想把这套时间同步纳入更完整的服务器初始化与排障流程,可以延伸阅读这篇美国 VPS 性能影响因素与优化和这篇香港服务器选型六大技术指标,把时间同步和带宽(指单位时间可传输的数据量)、IO、延迟这些指标一起纳入验收,才能在上线前就堵住隐患。
常见排障方向
时间同步失败的原因通常集中在这几个方向:第一步看服务状态,systemctl status chronyd 若 failed,用 journalctl -u chronyd 定位启动错误;第二步看网络,从服务器能否访问主时间源的 UDP 123 端口是最常见原因,主源上用 ss -ulnp | grep 123 确认监听,从机上用 nc -uvz 192.168.1.10 123 验证可达;第三步看时区,timedatectl 查看并修正。
特别提醒:不要在同一台服务器上同时运行 ntpd 与 chronyd,两者并存会互相竞争端口和状态,导致时间反复跳动,这是很多奇怪抖动案例的根本来源。
落地建议:把时间同步纳入上线初始化清单
多服务器时间一致性是分布式系统稳定运行的基础。用 chrony 搭建集群只需要配置主从时间源、验证同步三步,再配合自动化监控,就能把时间不一致引发的隐性故障挡在业务之外。建议你在每批新服务器上线时就把时间同步纳入初始化清单,并定期检查偏差值,而不是等故障出现后再排查。
在实践中,下面几点值得特别注意:
- 时区与偏移是两回事。时区影响显示,偏移影响精度;两者分别用
timedatectl和chronyc tracking核对,别混为一谈。 - 主从都要记录版本。chrony 大版本升级后行为可能有变化,升级前先备份
/etc/chrony.conf,升级后确认^*状态仍在,避免静默失效。 - 把时间验证写进发布前检查。无论你是部署数据库、消息队列还是定时任务,上线前先确认这一组机器时间基准一致,再谈业务联调。
如果你正在管理多台服务器、想把这类运维实践放到一台拥有完整 root 权限的主机上验证,可以考虑 VPS(虚拟专用服务器)主机方案或参考服务器排名与选型参考。Hostease 面向中文站长,提供带独立 root 权限的主机方案,选型阶段就把时间同步这类需求考虑进去,通常能减少后续运维返工。若你需要更高精度,还可研究 PTP(精确时间协议),但绝大多数场景下,一个正确配置并持续监控的 chrony 集群已经足够。
总结一下:多服务器时间同步不是”装个服务”就结束,而是”建集群 + 验证 + 监控”三件事闭环。先把主从时间源配好,再逐台验证同步,最后用自动化告警兜住漂移,就能把时间不一致这个隐蔽故障源挡住。
 微信扫一扫打赏
 支付宝扫一扫打赏