TL;DR:云主机(按需分配计算、存储和网络资源的服务器)磁盘扩容后,真正容易出问题的不是“控制台容量是否变大”,而是操作系统有没有识别新容量、LVM(逻辑卷管理,用于把物理磁盘组合成可动态调整的卷)链路是否完整、文件系统(管理文件存放和元数据的磁盘格式)是否在线扩展成功,以及业务 I/O 是否稳定。本文用论坛实测讨论的方式,教你如何把一次扩容拆成 5 个可验证环节,帮助站长避免“df -h 看起来正常,业务仍然写不进去”的尴尬。
一、为什么扩容后不能只看控制台容量
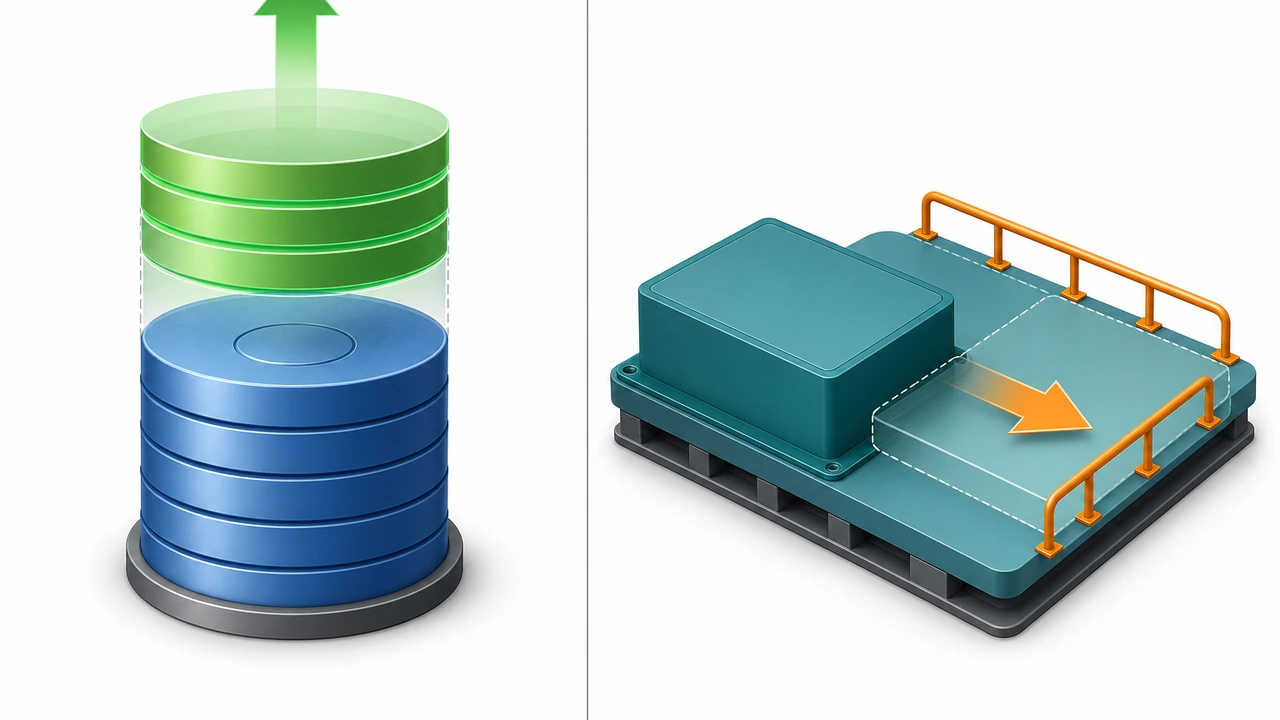
很多云主机(按需分配计算、存储和网络资源的服务器)面板会先完成虚拟磁盘层面的扩容,例如 80GB 扩到 120GB。但 Linux 里真正能被业务使用的空间,还要依次经过块设备、分区或 PV(Physical Volume,LVM 的物理卷)、VG(Volume Group,LVM 的卷组)、LV(Logical Volume,LVM 的逻辑卷)和文件系统(管理文件存放和元数据的磁盘格式)几层。任何一层没扩到,最终 df -h 都不会得到预期结果。
在我的测试环境中,最常见的误判有两个:第一,lsblk 已看到磁盘变大,但分区仍是旧大小;第二,LV 已扩容,但 ext4 或 XFS 文件系统(管理文件存放和元数据的磁盘格式)还没增长。前者会让 pvresize 找不到新增空间,后者会让 lvs 看着正常、df -h 仍旧不变。讨论类似 Linux 运维问题时,也可以参考 WHT 上的 技术教程版块,那里更适合放命令链路和复盘细节。
二、扩容前先记录 6 个基线指标
在线扩展的核心原则是:先证明扩容前状态,再证明扩容后状态。不要在业务高峰期边猜边做,尤其是数据库、图片站、日志系统这类持续写入的业务。建议先保留一份命令输出,后续如果出现 inode、挂载点或性能异常,至少知道变化发生在哪一层。
lsblk -f:记录磁盘、分区、LVM(逻辑卷管理,用于把物理磁盘组合成可动态调整的卷)层级和文件系统(管理文件存放和元数据的磁盘格式)类型。pvs; vgs; lvs:确认 PV、VG、LV 的大小、剩余空间和挂载关系,避免扩错卷。df -hT:记录挂载点、容量、使用率和文件系统(管理文件存放和元数据的磁盘格式)类型,例如 ext4 或 XFS。findmnt /data:确认业务目录对应的真实设备,防止把根分区和数据盘混在一起。iostat -xz 1 5:看扩容前 I/O 延迟,若 await 已长期超过 50ms,应先排查负载。
这里多说一句,快照或备份不是形式主义。扩容命令本身通常可以在线执行,但分区表调整、误选 LV、错误挂载路径都会放大风险。主机专区用户如果是生产站,建议在低峰窗口操作,并先确认控制台快照状态完成;
三、从块设备到 LVM 的操作链路
下面以常见路径举例:云硬盘从 80GB 扩到 120GB,数据目录挂在 /data,底层使用 LVM(逻辑卷管理,用于把物理磁盘组合成可动态调整的卷)。实际设备名可能是 /dev/vda、/dev/sda 或 /dev/nvme0n1,不要照抄设备名,先用 lsblk 确认。
lsblk
sudo partprobe
sudo growpart /dev/vda 2
sudo pvresize /dev/vda2
sudo lvextend -r -L +40G /dev/mapper/vgdata-lvdata
如果系统没有 growpart,Debian/Ubuntu 通常安装 cloud-guest-utils,RHEL 系通常安装 cloud-utils-growpart。执行 growpart /dev/vda 2 时,/dev/vda 和分区号 2 是分开的;写成 /dev/vda2 2 是新手常见错误。完成后先跑 pvs 和 vgs,如果 VG 的 free space 没变化,就不要继续扩 LV,应回头检查分区表是否真的增长。
四、文件系统扩展要分 ext4 和 XFS
LV 变大不代表文件系统(管理文件存放和元数据的磁盘格式)自动变大。ext4 和 XFS 的命令不同,路径也不同。ext4 通常对块设备执行 resize2fs,XFS 则对挂载点执行 xfs_growfs。这一步最适合先用 df -hT 确认类型,再选择命令。
df -hT /data
sudo resize2fs /dev/mapper/vgdata-lvdata
sudo xfs_growfs /data
如果是 ext4,resize2fs 支持在线扩容,但仍建议先确认 dmesg -T 没有 I/O error。XFS 只能扩不能缩,且必须在挂载状态下对挂载点执行命令。实际讨论中,有人把 xfs_growfs 指向块设备,结果命令直接报错;也有人把根目录 / 和数据目录 /data 搞混,导致扩容成功但业务目录还是满的。
如果你的业务是 WordPress 图片站、日志采集或备份仓库,扩容后还要看 inode。容量多了但 inode 用尽,一样会出现“磁盘未满却无法创建文件”的现象。可以用 df -ih 检查 inode 使用率,若长期超过 85%,下一次扩容前就要重新评估文件数量和目录拆分方式。更多站点迁移和存储路径调整经验,可以看 WordPress 网站迁移经验分享。
五、扩容完成后看哪些验证指标
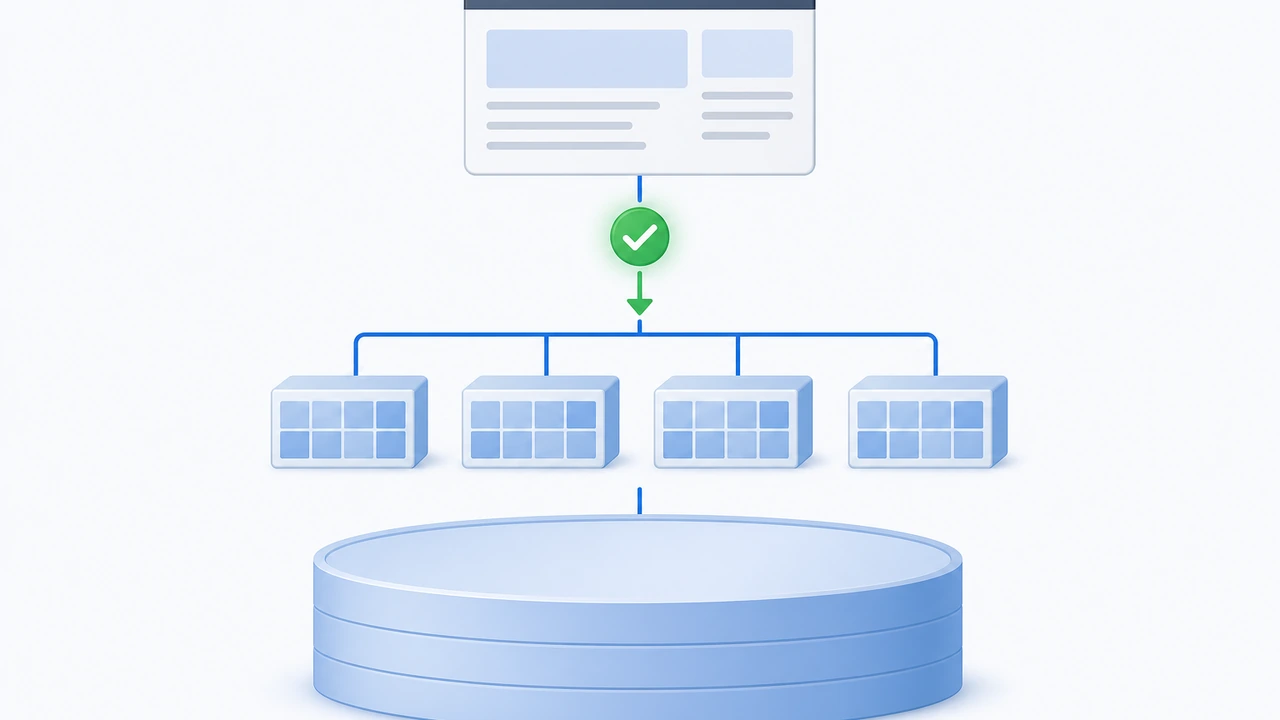
扩容后的验证不要只停在 df -h。论坛里经常有人贴一张容量截图就说完成,但生产环境更关心“业务是否稳定写入”。我的习惯是把验证拆成容量、挂载、I/O、日志和业务五层,任何一层异常都不算收工。
- 容量层:
lsblk、pvs、vgs、lvs、df -hT五个输出的容量链路必须一致。 - 挂载层:
findmnt /data显示的设备要与业务目录一致,/etc/fstab里建议使用 UUID 或稳定 mapper 路径。 - I/O 层:用
iostat -xz 1 10看扩容后 await、util 是否异常升高,低峰环境 util 长期 90% 以上要谨慎。 - 日志层:
dmesg -T | tail -50不应出现 reset、I/O error、filesystem warning 等关键词。 - 业务层:上传 一百兆 测试文件、写入数据库临时表或跑一次备份任务,验证真实写入路径。
如果你把云主机(按需分配计算、存储和网络资源的服务器)放在跨境访问场景,扩容本身不影响网络线路,但扩容窗口里的 I/O 抖动可能影响页面响应时间。这类主机用户在做海外站或中文业务时,可以把磁盘扩容和站点缓存刷新分开操作,避免同一时间既改存储又改 Web 层配置。选型和线路层面的讨论可延伸到 美国/香港主机备案与合规常见问题。
六、三类常见故障与回滚思路
扩容失败不一定要立刻重装系统。先定位是哪一层没生效,再决定回滚还是继续修。下面这张表适合贴到工单或论坛求助时使用,别人能更快判断问题点。
| 现象 | 优先检查 | 处理方向 |
|---|---|---|
lsblk 看到新容量,df -h 不变 |
分区、PV、LV、文件系统(管理文件存放和元数据的磁盘格式)是否逐层扩展 | 按 growpart → pvresize → lvextend → resize 顺序补齐 |
pvresize 后 VG 无可用空间 |
分区表是否刷新,设备名是否选错 | 执行 partprobe,必要时重启前先保存当前输出 |
| 容量变大但业务仍报写入失败 | inode、挂载点、权限、应用缓存路径 | 用 df -ih 和业务日志确认真实写入目录 |
七、给 主机专区用户的操作建议
总结一下,云主机(按需分配计算、存储和网络资源的服务器)扩容是一个典型的“控制台动作 + Linux 内部动作 + 业务验证”组合任务。建议把它当作一次小型变更来处理,而不是当作一条命令。对于 WHT 读者,最有价值的不是背命令,而是把每一步输出保存下来,这样后续无论自己复盘还是发帖求助,都能减少来回追问。
- 如果是首次操作,先在测试机用 10GB 扩到 15GB 演练一遍,确认 ext4 和 XFS 两套命令差异。
- 如果是线上站点,建议在低峰期执行,并把快照完成时间、命令输出、业务验证截图放到同一个记录里。
- 如果磁盘使用率已经超过 90%,不要只加 10GB;按近 30 天增长量估算,至少预留 2-3 个月缓冲。
- 如果业务依赖图片、日志或备份文件,扩容后同步检查 inode 和目录权限,不要只看容量百分比。
如果你需要稳定运行海外站点或跨境业务,可以考虑把磁盘扩容、备份策略、监控告警放在同一套运维规范里,而不是等磁盘满了再临时处理。如果你需要长期运行海外站点,中文支持、快照、监控和可预期的云主机场景都值得纳入选型;但无论使用哪家服务,真正决定扩容质量的,仍然是变更前基线、变更中命令顺序和变更后的验证指标。相关建站和服务器基础选型,也可以继续参考 cPanel 相关主机管理讨论。
 微信扫一扫打赏
 支付宝扫一扫打赏