很多跑 Kubernetes 或自建分布式服务的站长,都会遇到同一个问题:控制面数据到底存在哪里?答案通常是 etcd。它把集群的配置、密钥、服务发现信息全部集中在一处,一旦这台机器挂了,整个集群的调度和状态都会跟着瘫痪。这篇文章要解决的核心问题,就是如何把 etcd 部署成高可用集群,并在上线前验证哪些指标,才能避免”单点故障”变成”全线崩溃”。
为什么 etcd 的高可用不能靠运气
etcd 本质是一个分布式的键值存储,专门用来保存”配置类”数据。它和普通数据库最大的区别在于:它通过 Raft 共识算法在多个节点之间复制数据,只有超过半数的节点达成一致,写入才算成功。这意味着,如果你只部署一个节点,那么它宕机就等于数据丢失;如果你部署三个节点,那么允许挂掉一个,剩下两个仍能继续对外服务。
这里有一个关键概念叫 quorum(法定人数)。三节点集群的 quorum 是 2,五节点集群的 quorum 是 3。节点数越多,容错能力越强,但网络开销和写入延迟也会上升。所以,生产环境最常见的做法是部署奇数个节点(3 或 5),既保证容错,又不至于让性能拖后腿。需要特别提醒的是,etcd 集群的节点数必须是奇数,偶数节点不仅浪费资源,还会在故障时出现”平票”无法达成共识的尴尬局面。
部署前必须想清楚的三个前提
在动手部署之前,有几个前提条件如果没想清楚,后面再改会非常痛苦。
第一是节点之间的网络延迟。etcd 对节点间通信延迟非常敏感,官方建议节点间往返延迟(RTT)控制在 100 毫秒以内。如果三个节点分布在跨地域的机房,写入延迟会明显上升,甚至出现频繁的选举抖动。所以,etcd 集群的节点最好放在同一个机房或同一可用区内。
第二是磁盘性能。etcd 的每次写入都要先落盘(fsync),磁盘的 IOPS 直接决定写入吞吐。机械硬盘在并发写入时很容易成为瓶颈,建议使用 SSD,并预留足够的磁盘空间,因为 etcd 的数据文件会随着集群状态增长。这里顺带说明两个常见概念:VPS(虚拟专用服务器,在一台物理机上划分出的独立虚拟环境)和云服务器(通过虚拟化技术按需分配计算资源的服务器),它们都可以作为承载 etcd 节点的运行环境,区别主要在于资源隔离方式和弹性扩展能力。
第三是节点数量与容错预算。三节点允许挂 1 台,五节点允许挂 2 台。如果你的业务对可用性要求极高,可以选五节点;如果只是中小规模集群,三节点通常已经够用,还能省下两台机器的成本。
集群部署的核心步骤与验证指标
部署 etcd 集群时,最常用的方式是静态配置成员。每台节点都要配置一个唯一的 name、监听地址和初始集群成员列表。启动后,节点之间会通过 Raft 协议自动选举出 leader,并开始同步数据。
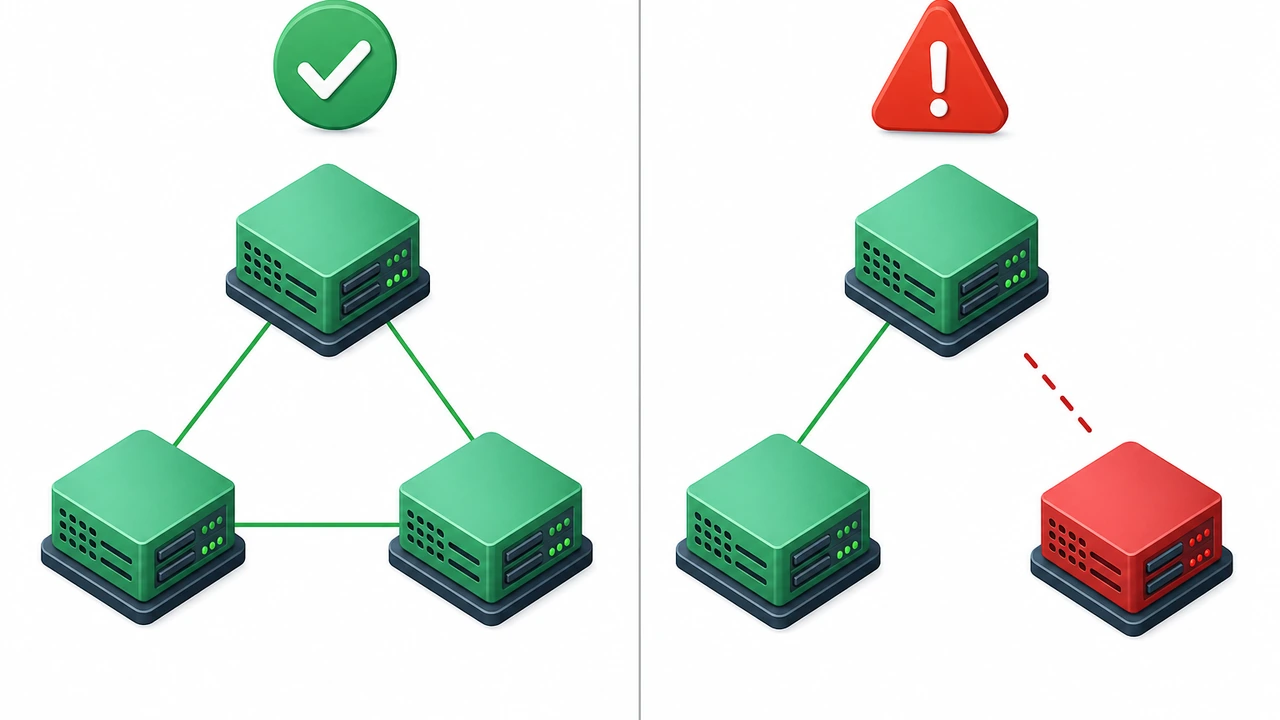
部署完成后,不能只看”进程起来了”就认为成功,必须逐项验证以下指标:
- 成员健康状态:用
etcdctl endpoint health检查每个节点是否都返回 healthy,任何一个节点异常都要立即排查。 - 集群成员列表:用
etcdctl member list确认节点数量、ID 和地址与预期一致,避免出现重复或错配的成员。 - leader 选举是否稳定:观察一段时间内 leader 是否频繁切换,如果 leader 频繁变动,说明网络或磁盘存在隐患。
- 写入与读取一致性:写入一个测试键,再从不同节点读取,确认数据在所有节点间保持一致。
- 故障切换演练:主动停掉一个节点,确认集群仍能正常读写,且剩余节点能重新选举出新的 leader。
备份与恢复:高可用的最后一道防线
即使集群本身高可用,也仍然需要备份。原因很简单:如果误操作删除了某个关键配置,或者集群遭遇了数据损坏,多节点复制并不能帮你找回被删掉的数据。etcd 提供了两种备份方式,各有适用场景。
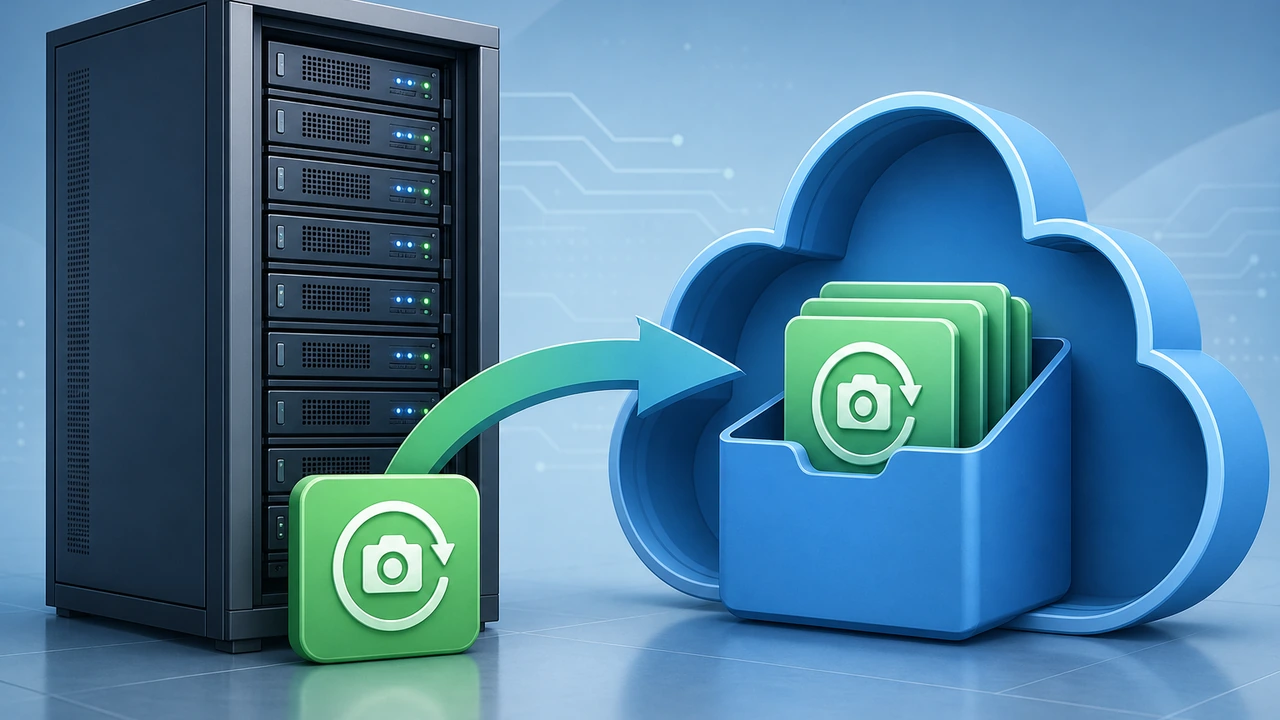
第一种是快照备份(snapshot)。它把当前整个数据目录打包成一个文件,适合做定期全量备份。恢复时,用 etcdctl snapshot restore 把快照恢复到新节点即可。快照的优点是简单可靠,缺点是只能恢复到备份时刻的状态,备份之后的新写入会丢失。
第二种是 WAL(预写日志)备份。WAL 记录了每一次写入操作,配合快照可以实现更细粒度的恢复。但 WAL 的恢复流程更复杂,对操作要求也更高,一般只在需要精确恢复时才使用。
在实际运维中,建议采用”定期快照 + 异地存储”的组合:每天定时生成快照,并同步到另一台机器或对象存储,这样即使整个机房出问题,也能从异地恢复数据。
恢复完成后,一定要用 etcdctl endpoint health 和成员列表再次验证,确认恢复后的集群状态正常,再接入业务流量。
上线前必须完成的验证清单
把上面的内容整理成一份可执行的清单,方便你在部署后逐项打勾:
- 节点数是否为奇数,且满足 quorum 要求(3 节点允许挂 1,5 节点允许挂 2)。
- 所有节点
etcdctl endpoint health均返回 healthy。 - 节点间网络延迟在 100 毫秒以内,磁盘为 SSD 且空间充足。
- 已配置定期快照,并同步到异地存储。
- 已演练过一次故障切换和一次快照恢复,确认流程可执行。
- 已设置监控告警,覆盖节点宕机、leader 频繁切换、磁盘空间不足等关键信号。
总结与行动建议
etcd 是分布式系统的”神经中枢”,它的高可用不能靠运气,而要靠合理的节点规划、严格的部署验证和可靠的备份机制。总结一下,三节点是最常见的起步配置,quorum 和网络延迟是决定集群稳定性的两个核心指标,快照加异地存储是数据安全的最后防线。
如果你正在规划自己的服务器集群,建议先按上面的清单做一次完整的部署演练,把故障切换和恢复流程跑通,再正式上线。如果你需要一台性能稳定、IOPS 有保障的服务器来承载 etcd 集群,可以参考中小企业如何选择合适的云服务器(云服务器指通过虚拟化技术按需分配计算资源的服务器)这篇选型指南,结合自己的预算和节点数量做决定。选机器时,重点关注磁盘类型和网络质量,这两点直接决定 etcd 的写入性能和集群稳定性,可以参考选择香港服务器的 6 大技术指标,以及海外 VPS 与境内 VPS 性能对比(VPS 即虚拟专用服务器,是在一台物理机上划分出的独立虚拟环境),把节点放在网络延迟可控的范围内。如果你需要,也可以先在小规模环境里验证,再逐步扩展到生产集群。Hostease 的服务器方案在磁盘和网络配置上提供了多种选择,适合作为承载 etcd 集群的候选环境。
 微信扫一扫打赏
 支付宝扫一扫打赏