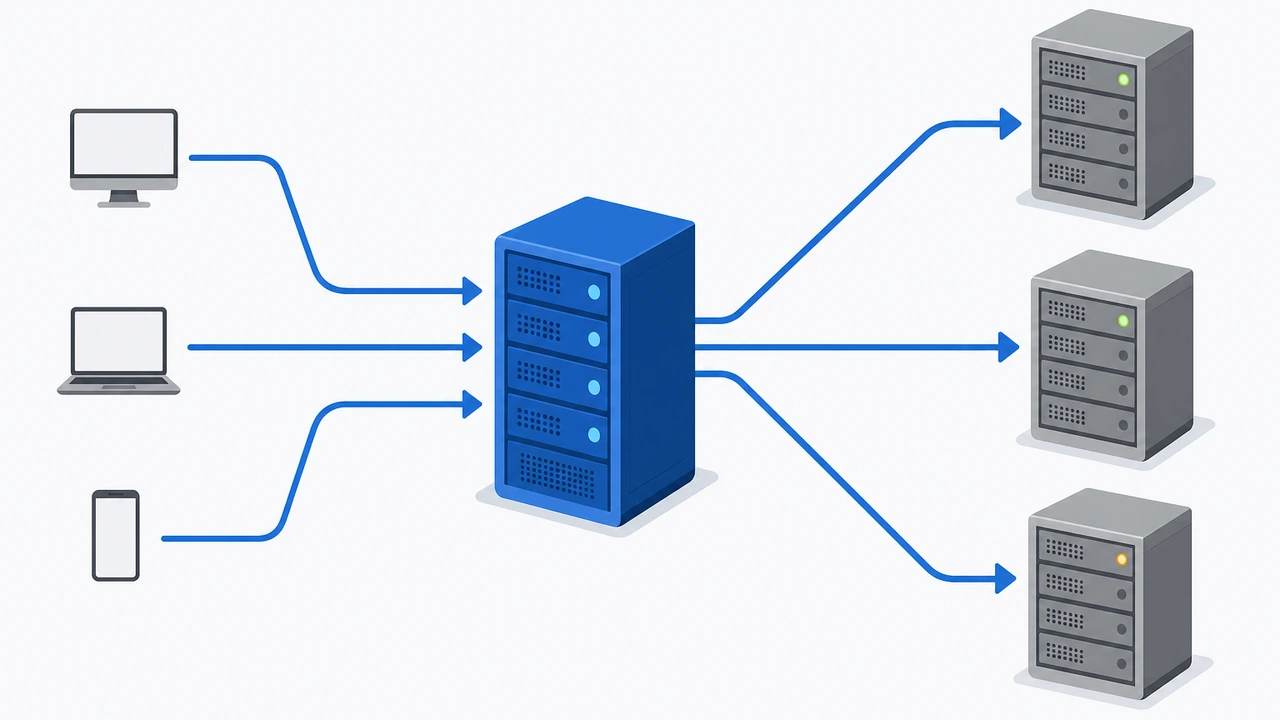
站点从单机走向集群,第一个踢到脚的就是 Nginx 的 upstream 后端池。很多人照着模板写完,nginx -t 一过就以为收工。这篇教你验证负载均衡和健康检查是否真的生效,以及该盯住哪些指标。下面按最小池子、选型策略、健康检查和排障清单逐项拆。
先从最小的 upstream 池确认流量真的分散了
动手前先立一个能跑的池子。upstream 块放在 Nginx 的 http 层级,声明后端地址,由 server 段 proxy_pass 引用:
upstream backend_pool {
    server 10.0.0.11:8080;
    server 10.0.0.12:8080;
    server 10.0.0.13:8080;
}
server {
    listen 80;
    server_name app.example.com;
    location / {
        proxy_pass http://backend_pool;
        proxy_set_header Host $host;
        proxy_set_header X-Real-IP $remote_addr;
    }
}
配完先 nginx -t 检查语法,再 nginx -s reload 重载,不要直接重启生产。验证是否真分发到三台机器,连续执行几次 curl -I http://app.example.com,再去各后端日志看来源 IP,确认请求分散到不同节点。
这两个头是反向代理的兜底项:Host 保证后端拿到原始域名而非内网 IP,多站点共用一个池不会串站;X-Real-IP 把真实客户端 IP 传给后端,否则限流登录态都会错位。
负载均衡策略:轮询、权重、IP Hash 分别该验证什么
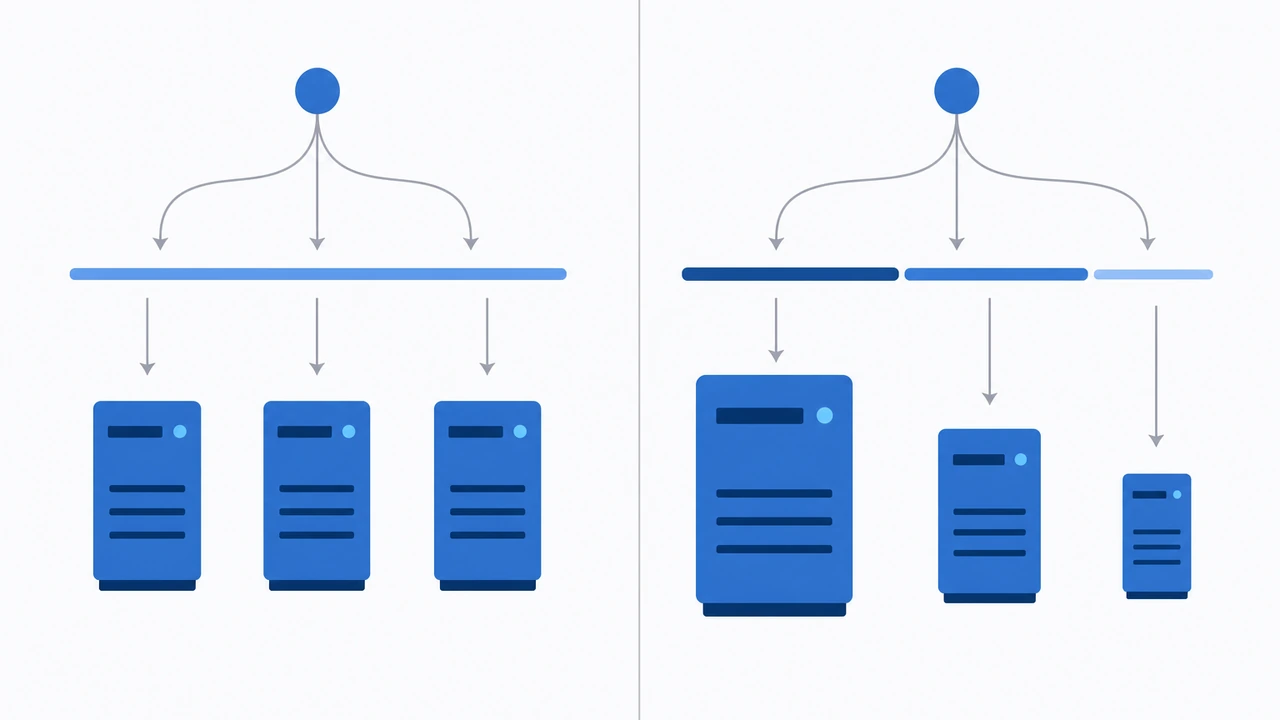
upstream 不写策略时默认是轮询(Round Robin),请求按顺序轮流发给每个后端,适合后端规格接近、链路简单的场景。它实现最简单,但只要一台节点配置偏低,慢节点就容易拖成整个链路的瓶颈。
这时可以给节点加权重,让算力更强的机器承担更多请求:
server 10.0.0.11:8080 weight=3;
server 10.0.0.12:8080 weight=2;
server 10.0.0.13:8080 weight=1;
权重值越大被选中概率越高,适合“机器规格不同、按算力分配”的集群。验证时用压测工具按固定 QPS 打一段时间(如 ab -n 6000 -c 100),统计三台后端命中数,应大致落在 3:2:1 附近。若偏离明显,多是某台节点拖慢整体。
另一种常见策略是 ip_hash,按客户端 IP 固定分配,让同一用户尽量落到同一台后端,对依赖本地会话、又不想做集中式存储的应用很友好。但它按 IP 段分布,扩容缩容时偏移明显。验证时抓同一来源 IP 连续请求确认命中同一台,再换 IP 看是否换节点。
如果响应时间差异大、连接数波动明显,可用 least_conn 最小连接策略,把新请求分给活跃连接最少的那台,切换只需改一个指令再 reload。
健康检查:被动剔除还是主动探测,别只验端口通
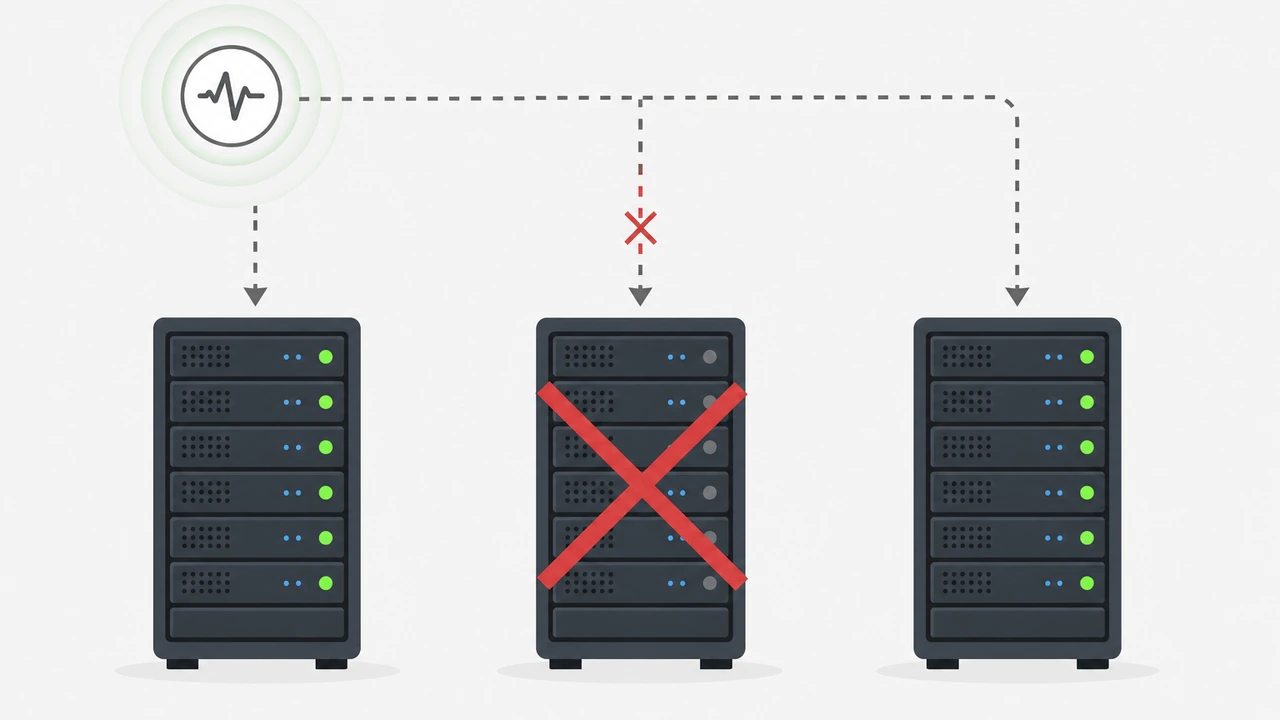
负载均衡只解决“怎么分流量”,真正让后端池在高可用(High Availability,指系统在部分组件故障时仍能对外服务)上立住的是健康检查。Nginx 分两类:被动检查在请求经过时观察后端是否失败,主动检查由 Nginx 定期探测,没有流量也能提前发现异常节点。
被动检查是开源版 Nginx 默认自带、无需额外编译的能力,用 max_fails 和 fail_timeout 就能控制:
server 10.0.0.11:8080 max_fails=3 fail_timeout=30s;
server 10.0.0.12:8080 max_fails=3 fail_timeout=30s;
server 10.0.0.13:8080 max_fails=3 fail_timeout=30s;
含义是:在 fail_timeout(30 秒)时间窗内,某台后端连续失败达到 max_fails(3)次,就标记为不可用,30 秒内不再转发,时间过后自动重新探测。默认判失败依据是连接失败、超时和 5xx。它零成本、直接能用,缺点是没有访问就不触发——夜间无流量时故障节点可能一晚上不被剔除。验证时手动停掉某台后端,持续打流量,观察自动切走与恢复回池。
若对可用性要求更高,希望没真实请求也能及时发现故障,就要用主动健康检查。开源版默认不带,需官方商业版 health_check 或社区 ngx_http_upstream_check_module 补丁。nginx -V 须有 --with-http_upstream_check_module 才算具备,否则 nginx -t 会报 “unknown directive”。
以社区补丁模块为例,配置长这样:
server 10.0.0.11:8080;
server 10.0.0.12:8080;
server 10.0.0.13:8080;
check interval=5000 rise=2 fall=3 timeout=2000 type=http;
check_http_send "HEAD /health HTTP/1.0\r\n";
check_http_expect_alive http_2xx;
这段配置每 5 秒(interval=5000)发一次 HEAD /health;连续成功 2 次(rise=2)判定恢复,连续失败 3 次(fall=3)判定故障停止转发。关键是后端要提供轻量 /health 接口,返回 2xx 才算可用,只查端口通不够,很多故障是进程活着但应用已卡死。
排障与验证:别让配置只停在“能加载”
写好 upstream 只是开始,真正的坑常在验证环节。通过 nginx -t 后,建议顺序跑下面几个动作确认池子在按预期工作。
先看实时连接分布,执行 ss -tn state established '( dport = :8080 )' 观察各节点连接数是否接近预期比例。再看错误日志 tail -f /var/log/nginx/error.log,重点抓 “no live upstreams” 或超时重试,以及主动检查输出的探测失败记录,这是判断健康检查生效的最直接证据。
这里有个容易踩的细节:连接失败和超时能触发被动剔除,但后端返回的 502/504 这类由 Nginx 产生的错误通常不会让节点下线。想让应用层故障也被识别,要么加主动健康检查接口,要么让异常直接断开连接。连接管理可与 这篇 VPS 速度优化思路 对齐内核连接队列。
把后端池接进日常运维,交付前做一次完整演练
后端池不是配完就一劳永逸。交付前建议做一次演练:先在测试环境停掉某台后端,确认流量几十秒内自动切走,再恢复节点看能否回池。通过后把访问和错误日志接进监控,重点盯 upstream 超时与重试条目,这样后端真出问题时你能及时看到苗头。
对运行在 VPS(虚拟专用服务器)上的中小站点来说,upstream 加被动健康检查基本够用;只有流量大、业务对可用性有硬指标,才值得为主动检查选用带模块的 Nginx。可以先拿一台真实 VPS 主机 搭出最小池子,逐步叠加权重和健康检查。
总结一下:验证指标核心就三层。第一层看负载均衡,用日志和 ss 确认请求按轮询、权重或 IP Hash 的预期比例分配;第二层看被动健康检查,主动停掉某台后端,确认 max_fails 到点能自动切走并回池;第三层看主动检查,确认 /health 的 2xx 判定与 fall 阈值真的生效。按“先最小池子、再加权重、最后上健康检查”的顺序落地,每步都跑验证命令,不确定就回到 ss 与日志找证据。这套思路也适用于其他反向代理场景。
如果你需要在一台有独立 root 权限的服务器上实测这些步骤,可以参考 这篇美国独立服务器价格评估 先对齐测试机规格。把验证命令落进真实环境,比把配置停在“能加载”更有意义。
 微信扫一扫打赏
 支付宝扫一扫打赏